
前回の記事では、GadgetStreem Radar(GSR)を作り始めた理由を紹介しました。
情報がないのではなく、情報が多すぎる。
その中から「今、何を見るべきなのか」を探すためのRadarを作りたい。
では、実際の開発で最初に何を作ったのか。
検索画面でも、ランキング画面でもありません。
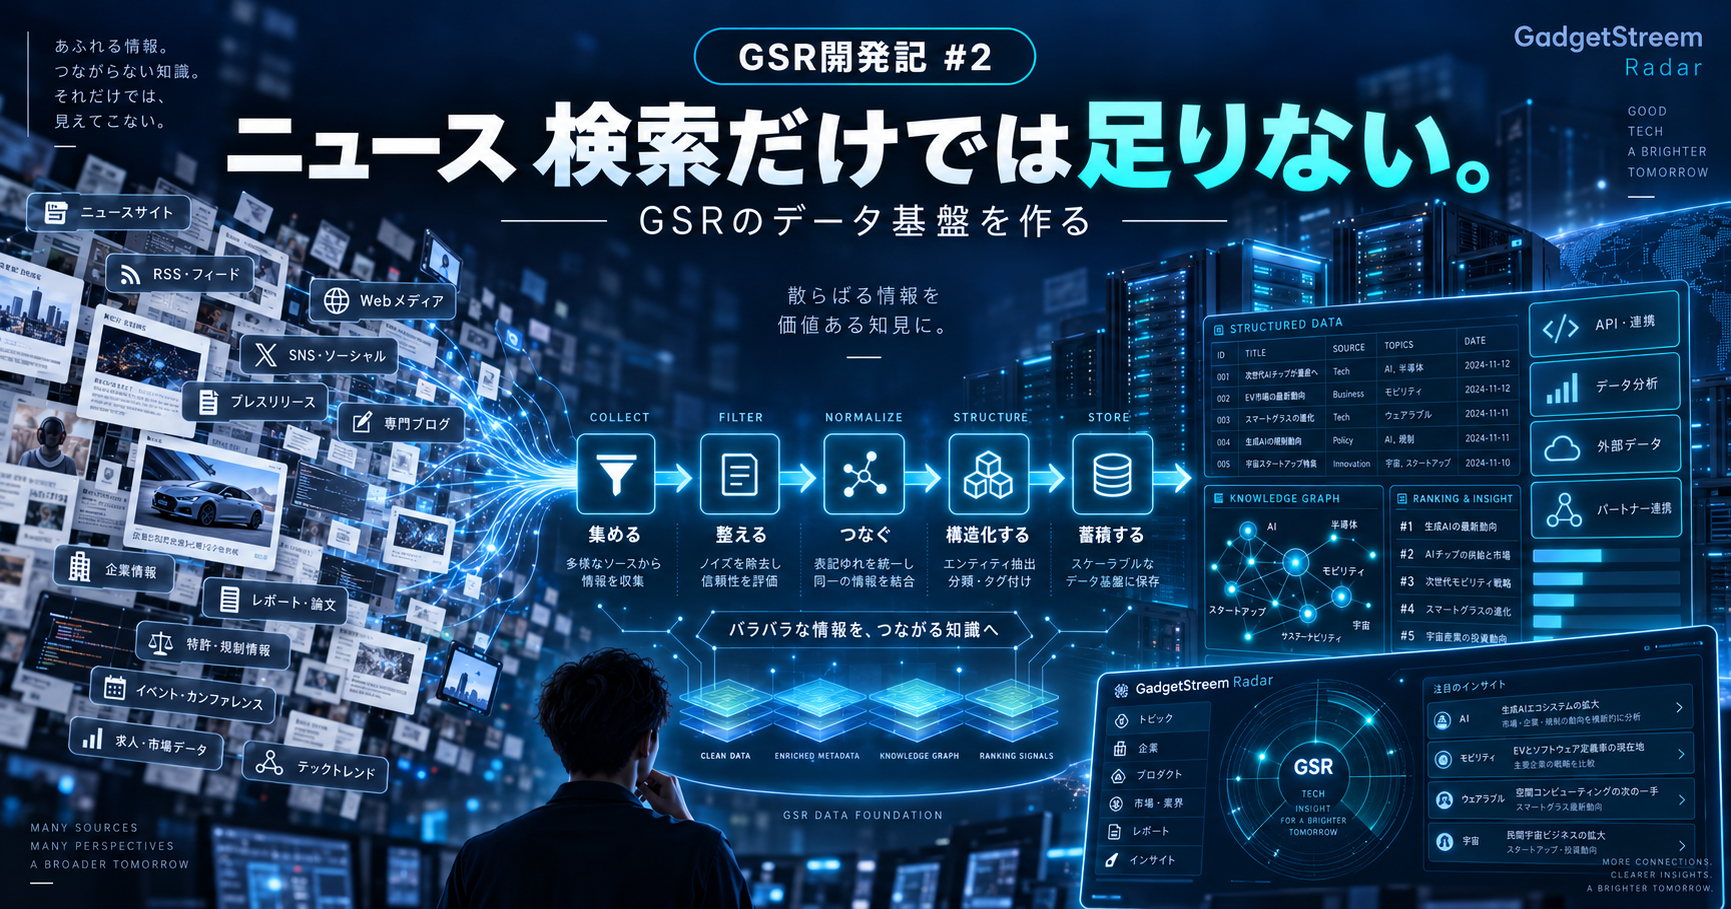
最初に作ったのは、ニュースを正しく扱うためのデータ基盤でした。
ニュースを集めるだけでは、Radarにはならない
ニュース記事のURLとタイトルをデータベースへ保存するだけなら、それほど複雑ではありません。
しかしGSRでやりたいことを考えると、それだけでは足りません。
例えば、同じニュースが複数のサイトに掲載されていたらどうするのか。同じ記事を再取得したとき、別の記事として数えてしまわないか。メーカー名の表記が違っていても同じ企業として扱えるか。情報源が取得可能でも、GSRで利用してよい情報源なのか。
さらに将来的には、1時間、24時間、7日、30日といった時間軸で情報の動きを見たいと考えていました。
そのためには、ニュースを「保存する箱」ではなく、どこから来た情報なのか、何の情報なのか、以前と同じなのか、後からどう処理されたのかを追跡できる構造が必要になります。
最初に作ったのは、12個のRadar用データテーブル
2026年7月26日、GSRの最初の永続データモデルを実装しました。
ここでは、メーカー、情報源、取得履歴、取得した元データ、正規化後の記事、ニュースのまとまり、ランキング、要約といった役割を最初から分離しています。
代表的なものには、次のようなデータがあります。
- メーカーを管理する
radar_manufacturers - 情報源を管理する
radar_sources - いつ何を取得したかを記録する
radar_collection_runs - 取得直後の情報を保持する
radar_raw_source_items - 整理された記事情報を扱う
radar_articles - 同じ話題の記事をまとめるための
radar_news_clusters - 将来のランキング結果を保持する
radar_ranking_scores - 要約の生成・レビュー状態を管理する
radar_summary_metadata
ベースの移行では12個のRadar用テーブルを作り、その後メーカーの公式ドメインを管理する仕組みも追加しました。
重要なのは、これらを一つの巨大なテーブルにしなかったことです。
取得した事実と、後から行う判定やランキングを分ける。
これによって、後から判定方法を変更しても「元の情報が何だったのか」を追えるようにしました。
記事本文を丸ごと保存しない
もう一つ、初期段階で決めたことがあります。
GSRのデータモデルには、ニュース記事の本文全文や生のHTMLを無制限に保存するためのフィールドを用意していません。
保持するのは、URL、タイトル、許可された範囲の抜粋、公開日時、識別情報、ハッシュなど、Radarの処理に必要な情報が中心です。
これは単なる容量削減ではありません。
取得できることと、保存・再利用してよいことは別だからです。
この考え方は、後にGSRが情報源ごとの利用条件を細かく確認する「rights-first」の設計へ進むとき、そのまま重要な土台になりました。
20メーカーを同じ基準で扱うManufacturer Master
次に作ったのが、Manufacturer Masterです。
GSRの初期バージョンでは、20メーカーを対象としてメーカー情報をバージョン管理する仕組みを作りました。
対象はApple、Google、Samsung、Sony、Nintendo、Microsoft、NVIDIA、AMD、Intel、ASUS、MSI、GIGABYTE、Lenovo、Dell、HP、Xiaomi、OPPO、Anker、UGREEN、Nothingです。
単にメーカー名を20個登録したわけではありません。
正式名称、表示名、別名、地域、公式サイト、公式ドメインなどを管理し、表記が少し違っても同じメーカーとして扱えるための基準を作っています。
別名についても、Unicodeの正規化、大文字・小文字の統一、記号や空白の整理などを行い、曖昧な一致をできるだけ避ける設計にしました。
ここでも重要な境界があります。
「このドメインはメーカー公式である」と確認できることは、「そこから自動取得してよい」という意味ではありません。
ドメインの所有関係と、データ取得の許可は別々に管理します。
情報源にも「取得できる」以外の状態を持たせる
そのためGSRでは、情報源を管理するSource Registryにも複数の状態を持たせました。
技術的にアクセスできるかだけでなく、利用可否、ライセンス状態、保持方針、本番取得を許可するかどうかを分離します。
本番取得を有効にできるのは、必要な承認条件を満たし、明示的にProductionのスイッチを有効にした情報源だけです。
つまり、
「アクセスできたから使う」ではなく、「使ってよいと確認されたものだけを使う」
という設計です。
実際に取得する仕組みも、最初はインターネットへ出なかった
データモデルとManufacturer Masterの次に作ったのが、Ingestion Frameworkです。
これは情報源からデータを取得し、GSRへ取り込むための共通基盤です。
ただし、最初の実装ではいきなり実際のメーカーサイトへアクセスしませんでした。
公式メーカーFeedを想定したテスト用RSSと、ニュース配信元を想定したテスト用RSSを用意し、ネットワークアクセスなしで取得処理そのものを検証しました。
RSS 2.0とAtomを読み取り、外部ID、URL、タイトル、許可された範囲の抜粋、公開日時、識別用ハッシュなどを抽出します。
一方で、不正なXML、大きすぎるデータ、過剰な件数、不正なURL、不完全な記事、無効な日時などは拒否します。
実際の情報源を触る前に、まず「取得処理が安全に失敗できるか」を確認したわけです。
同じ記事を何度取っても増殖させない
ニュース収集では、同じ情報を何度も取得することがあります。
そこでGSRでは、取得データに識別用のハッシュを持たせました。
初めて見る情報なら新しいレコードとして保存する。
同じ情報で内容も変わっていなければ、重複として扱う。
同じ情報でも内容が変わっていれば、新しいRevisionとして履歴を残す。
この仕組みによって、同じRSSを何度取得しても記事が無限に増える状態を防ぎつつ、後から内容が更新された場合はその変化を残せます。
定期取得についても、同じ時間枠を再実行した場合は同じ実行として扱えるよう、冪等性を持たせました。
この段階では、まだランキングを作っていない
ここはGSRの開発ストーリーを正確に伝えるうえで重要です。
データモデルには、将来使う1時間、24時間、7日、30日のランキングを保持できる構造まで用意しました。
しかし、この段階でランキング機能が完成していたわけではありません。
記事の正規化、ニュースのクラスタリング、ランキング方法、要約生成、一般公開API、Web UI、バックグラウンドSchedulerなどは、まだ後の工程です。
まず、
メーカーを正しく識別できる。
情報源を管理できる。
取得した結果を追跡できる。
同じ情報を安全に再取得できる。
そこまでを先に固めました。
「動くもの」より先に「壊れ方」を作った
振り返ると、GSR初期開発の特徴はここにあります。
通常なら、まずニュース一覧を表示して「動いた」と確認したくなります。
GSRではその前に、データの出所、重複、更新履歴、情報源の権限、本番利用の境界を作りました。
その結果、次の段階で実際のメーカー情報源を使い始めたとき、ある重要な違いを正しく記録できるようになります。
取得できた情報源と、取得できなかった情報源です。
次回:AppleとNVIDIAは取れた。でもSonyは取れなかった
次回は、いよいよGSRで実際のメーカー公式情報を使ったShadow Operationへ進みます。
AppleとNVIDIAでは取得に成功しました。
一方、SonyではHTTP 403が発生しました。
このときGSRは、別の方法で無理に取りに行くのではなく、blocked_by_originとして情報源単位で隔離する設計を選びます。
この判断が、後のGSRのSource Health、Shadow Cycle、そしてrights-firstの考え方につながっていきます。
GSR Development Story
Vol.1 ニュースを「探す」から「見極める」へ
Vol.2 GSRのデータ基盤を作る ← 今回
Vol.3 AppleとNVIDIAは取れた。でもSonyは取れなかった
Vol.4 5回のShadow Cycleで検証したこと
Vol.5 なぜGSRは28日待ったのか
Vol.6 AIにニュースを書かせる前に作った境界線
Vol.7 公式サイトだけではGSRを完成できなかった
Vol.8 GDELTとWikimediaへ
Vol.9 本番データを触る前に、何度も止めた理由
Vol.10 GSRはいまどこまでできているのか
Vol.11 GPIとGSRが揃うとGadgetStreemは何になるのか
コメント