
前回の記事では、GadgetStreem Radar(GSR)がニュース検索画面を作る前に、データモデル、Manufacturer Master、Source Registry、Ingestion Frameworkといった「ニュースを正しく扱うための土台」を作ったことを紹介しました。
では、その基盤を実際のメーカー公式情報へ接続するとどうなるのか。
2026年7月末、GSRは初めて実際のメーカー公式Feedを使ったShadow Collectionへ進みました。
結果は、すべて成功ではありませんでした。
AppleとNVIDIAは取得できた。
しかし、Sonyは取得できなかった。
GSRにとって、この「失敗」はかなり重要な出来事になりました。
最初に選んだのは5つの公式Feed
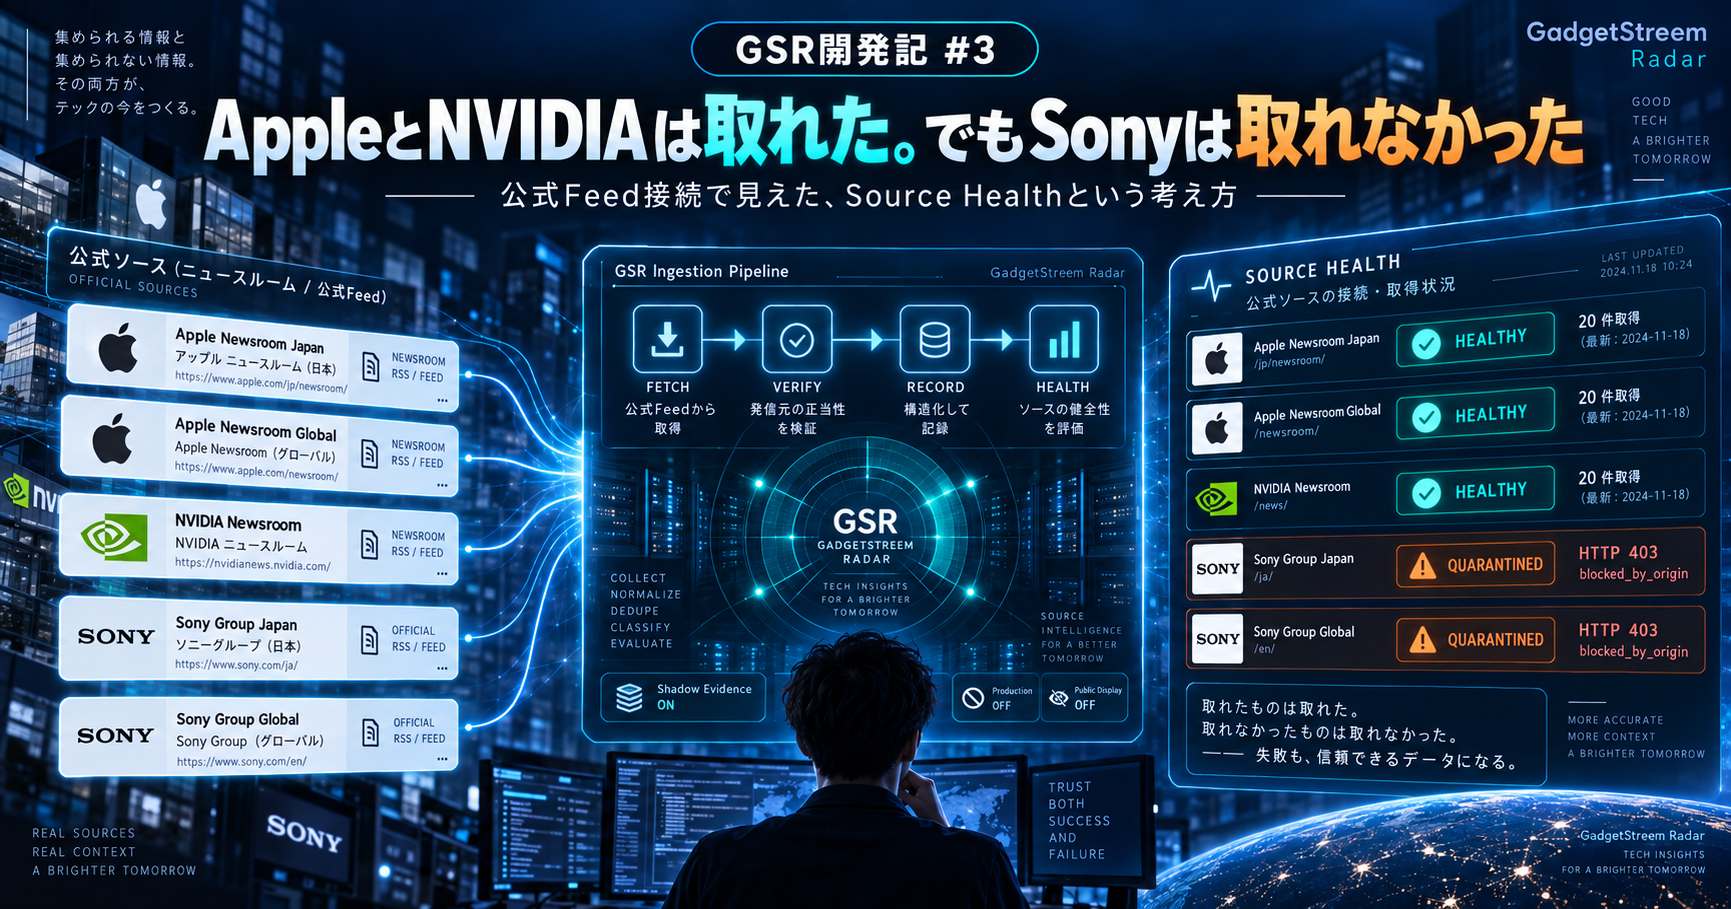
最初の実データ検証では、開発コストを抑えながらメーカー自身が公開している情報を取得するため、5つの公式Feedを対象にしました。
- Apple Newsroom Japan
- Apple Newsroom Global
- Sony Group Japan
- Sony Group Global
- NVIDIA Newsroom
いずれも、まずはGSR内部で検証するShadow用途です。
この時点では、Production Collection、Public Display、自動Scheduler、Normalization、Rankingはすべて無効のままです。
つまり、実際の情報源へ接続はするものの、取得した結果をそのままGSRの公開サービスへ流すことはありません。
まず内部で観測し、安全に扱えるかを確認する。
Appleは取得成功
実際に最初のCollectionを実行すると、Appleの2つのFeedは正常に応答しました。
Apple Newsroom Japanでは20件。Apple Newsroom Globalでも20件。合計40件の情報を受理できました。
HTTPの応答も正常で、GSRのIngestion Frameworkを通してメタデータを処理できることを確認できました。
NVIDIAも20件取得できた
NVIDIA Newsroomでも同じように取得に成功しました。こちらも20件が受理されました。
Apple Japan 20件。Apple Global 20件。NVIDIA 20件。
合計60件。
この3つの情報源については、最初の実ソース検証を正常に通過しました。
しかし、Sonyでは同じ結果になりませんでした。
SonyはHTTP 403
Sony Group Japanへアクセスすると、返ってきたのはHTTP 403でした。
Sony Group Globalも同じです。
GSRでは、この状態を一時的なネットワークエラーではなく、恒久的な取得失敗として扱いました。
内部ではRadarPermanentFetchErrorとして記録されます。
URLは存在していても、GSRの取得処理からは利用できない。
403なら、別の方法で取ればいい?
技術的には、別のURLを探す、HTMLページを直接取得する、ブラウザに近いUser-Agentを使う、リダイレクト先を追う、別の非公式ソースへ切り替える、といった方法も考えられます。
しかしGSRでは、それを行いませんでした。
「取得できない」という事実をそのままシステムの状態として残すことを選びました。
blocked_by_origin
Sony JapanとSony Globalには、blocked_by_originという理由を付けました。
そしてSource Healthを、quarantinedに変更しました。
Quarantineは「この情報源を削除する」という意味ではありません。
Source Registryには残し、過去の失敗記録も残します。ただし、通常の繰り返し取得対象からは外します。
何度も同じ403を発生させない。
その後のShadow Cycleでは、Apple Japan、Apple Global、NVIDIAの3つだけが取得対象になります。
Sony JapanとSony Globalは、明示的な再確認を行わない限り、自動的には再試行しません。
なぜ再試行し続けなかったのか
すべての失敗を同じように扱うのは危険です。
一時的な通信障害やサーバーエラーなら、時間を空ければ成功するかもしれません。一方、今回のSonyのような恒久的な取得失敗では、同じアクセスを延々と繰り返すべきではありません。
そこでGSRのSource Healthには、unseen、healthy、degraded、quarantinedという状態を用意しました。
単純な「成功 / 失敗」ではなく、情報源そのものの健康状態を管理する仕組みへ進化しました。
「取得できない」をデータとして扱う
GSRが管理するのは、ニュースだけではありません。
あるメーカーだけ情報が少ないとき、本当にニュースが少ないのか、それともGSRがそのメーカーの情報源を取得できていないのか。この二つはまったく意味が違います。
Source Healthを別に持っていれば、その違いを区別できます。
取得成功は「利用許可」ではない
AppleやNVIDIAから情報を取得できたからといって、その情報を商用サービスで自由に利用できると判断したわけではありません。
技術的に取得できること。利用条件を満たすこと。保存してよいこと。分析へ利用してよいこと。公開してよいこと。これらは別々の問題です。
そのため、この時点の5つの情報源はいずれもShadow Evidenceとして扱われ、Production CollectionやPublic Displayには接続していません。
失敗したSonyを、成功したことにしなかった
今回の開発で重要だったのは、Sonyから情報を取得できなかったこと自体ではありません。
取得できなかったものを、無理に取得できる状態へ変えなかったことです。
GSRでは、Apple Japan:Healthy、Apple Global:Healthy、NVIDIA:Healthy、Sony Japan:Quarantined / blocked_by_origin、Sony Global:Quarantined / blocked_by_origin、という状態をそのまま残しました。
取れたものは取れた。
取れなかったものは取れなかった。
後からデータを信頼するためには、非常に重要な原則です。
そして、1回成功しただけでは終わらなかった
AppleとNVIDIAの3ソースが正常に取得できることは確認できました。Sonyの2ソースについても、安全に隔離できました。
しかし、1回成功しただけでは翌日も動くのか、数日後も動くのか、重複を正しく処理できるのかは分かりません。
そこで次に始めたのが、Shadow Cycleの継続観測です。
次回:5回のShadow Cycleで検証したこと
次回のVol.4では、AppleとNVIDIAの3つのHealthyな情報源を使ってShadow Cycleを継続した過程を紹介します。
GSRは最終的に、5回のOperational Cycleを蓄積しました。
しかし、5回正常に動いたあとも、次の工程へ進みませんでした。
理由は一つ。
観測期間が、まだ10日しかなかったからです。
GSRが要求していたのは28日。この話はVol.4、そしてVol.5へ続きます。
GSR Development Story
Vol.1 ニュースを「探す」から「見極める」へ
Vol.2 GSRのデータ基盤を作る
Vol.3 AppleとNVIDIAは取れた。でもSonyは取れなかった ← 今回
Vol.4 5回のShadow Cycleで検証したこと
Vol.5 なぜGSRは28日待ったのか
Vol.6 AIにニュースを書かせる前に作った境界線
Vol.7 公式サイトだけではGSRを完成できなかった
Vol.8 GDELTとWikimediaへ
Vol.9 本番データを触る前に、何度も止めた理由
Vol.10 GSRはいまどこまでできているのか
Vol.11 GPIとGSRが揃うとGadgetStreemは何になるのか
コメント